Automatisation des tests : sécuriser les livraisons sans multiplier les scripts fragiles
Publié par : Éloïse Caradec-Lafarge — Rédactrice spécialisée en tech
L’automatisation des tests consiste à confier à des outils l’exécution de vérifications logicielles et la comparaison des résultats avec un comportement attendu. Elle sert surtout à détecter rapidement les régressions, sans répéter manuellement les mêmes manipulations. Pour qu’elle soit rentable, il faut choisir les bons scénarios, disposer de données fiables et prévoir la maintenance dès le départ.
Automatiser des vérifications, pas déléguer toute la qualité
Un test automatisé prépare une situation, exécute une action puis vérifie un résultat grâce à une assertion. Par exemple, il crée un panier, applique une remise et contrôle le montant obtenu. Contrairement au test manuel, chaque exécution ne nécessite pas qu’une personne reproduise les étapes et inspecte le résultat.
Le bénéfice est particulièrement net pour les contrôles répétitifs : exécutions fréquentes, résultats comparables et retour rapide aux développeurs. Atlassian évoque ainsi des situations où un build pouvait rester plusieurs jours dans l’équipe QA avant qu’un retour parvienne au développement. L’intégration des tests au pipeline CI/CD vise à raccourcir cette boucle.
Mais un script ne vérifie que ce qui a été prévu. Une suite entièrement verte ne prouve ni l’absence de défauts ni la pertinence du produit. L’exploration manuelle reste indispensable pour découvrir des comportements inattendus, apprécier la clarté d’un parcours ou examiner une fonctionnalité encore mouvante. Les contrôles automatisés d’accessibilité et de sécurité apportent eux aussi une couverture partielle, à compléter par une analyse adaptée.
L’automatisation devient une béquille dangereuse lorsqu’elle compense durablement une application difficile à tester : attentes arbitraires, comptes partagés, manipulations complexes pour atteindre un écran. Avant d’ajouter des scripts, améliorez les points d’appui du logiciel : identifiants d’interface stables, données réinitialisables, composants isolables et diagnostics lisibles. Cette testabilité réduit la fragilité à la racine, au lieu de simplement déplacer le travail manuel vers le dépannage des tests.
Construire une couverture par niveaux et par risques
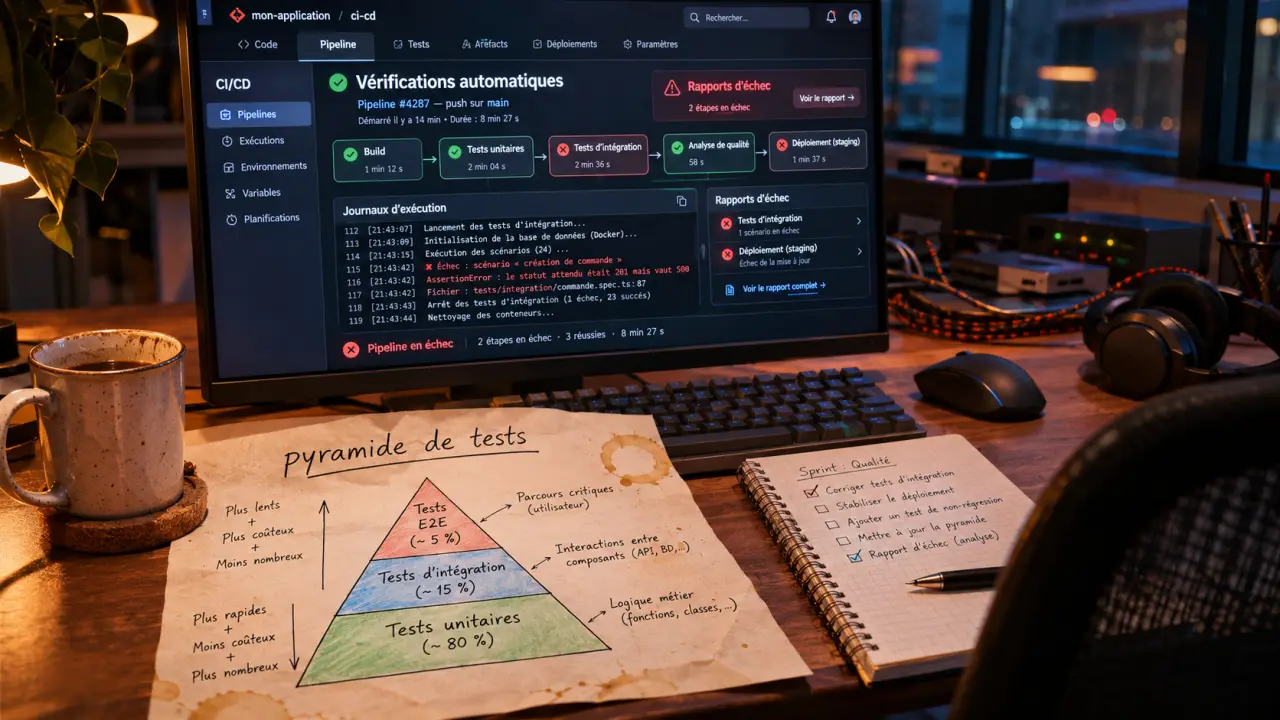
La pyramide de test propose un équilibre : beaucoup de vérifications rapides et ciblées, puis des contrôles d’intégration et un nombre plus limité de parcours complets. Ce n’est pas une répartition obligatoire. Elle rappelle surtout qu’un test traversant toute l’application coûte généralement davantage à exécuter et à diagnostiquer qu’un test isolé.
| Niveau ou famille | Ce que le test vérifie | Exemple utile |
|---|---|---|
| Unitaire | Une fonction ou un composant isolé | Calcul d’une remise et traitement des valeurs limites |
| Intégration | La coopération entre plusieurs composants | Enregistrement d’une commande dans la base de données |
| API | Le comportement d’une interface de service | Rejet d’une requête sans autorisation |
| Bout en bout | Un parcours complet du point de vue utilisateur | Achat jusqu’à la confirmation de commande |
| Performance | Le comportement sous une charge définie | Temps de réponse pendant des accès simultanés |
Ces catégories se recoupent : un test d’API peut être fonctionnel et contribuer à la non-régression. « Fonctionnel » décrit la conformité aux exigences ; « régression » désigne la recherche de dégradations après un changement. Évitez donc de compter ces familles comme des couvertures indépendantes.
Prioriser les scénarios qui protègent réellement le produit
Commencez par croiser criticité, fréquence d’exécution, stabilité et coût de maintenance. Une règle de facturation stable, vérifiée à chaque livraison, constitue un bon candidat. Un écran provisoire rarement utilisé justifie moins souvent un script d’interface coûteux. Un parcours rare mais susceptible de provoquer une perte de données peut néanmoins être prioritaire.
Wefiit cite la règle des 20/80, selon laquelle 20 % des fonctionnalités représenteraient 80 % des fonctionnalités utilisées. Prenez-la comme une invitation à étudier les usages, pas comme une mesure de votre application. Complétez les parcours fréquents par les risques métier majeurs, les incidents passés et les cas limites.
Choisir un outil sur un scénario réel, pas sur une démonstration
Le bon outil correspond au logiciel, aux compétences de l’équipe et à son infrastructure. Distinguez les frameworks pilotés par du code, les solutions low-code et les approches no-code. Ces dernières peuvent faciliter la création de scénarios, mais elles ne suppriment ni la conception des assertions ni le diagnostic des échecs.
Pour une présélection, JUnit ou pytest peuvent convenir aux tests liés au code, Playwright ou Selenium aux parcours web, et k6 ou JMeter aux tests de performance. Mabl fait partie des solutions proposant une approche low-code. Ces exemples répondent à des besoins différents : aucun ne remplace à lui seul une stratégie de test.
- Compatibilité : langages, navigateurs, applications et environnements pris en charge.
- Intégration CI/CD : exécution sans interaction, gestion des secrets et rapports exploitables.
- Diagnostic : journaux, traces et éléments permettant de reproduire un échec.
- Maintenance : réutilisation des composants, lisibilité et versionnement des scénarios.
- Coût total : licences, infrastructure, formation et temps consacré aux réparations.
Validez votre sélection avec un petit pilote représentatif. Automatisez un scénario utile, faites-le fonctionner dans le pipeline, puis modifiez volontairement la fonctionnalité testée. Vous évaluerez ainsi la facilité de création, mais aussi l’effort de maintenance, souvent moins visible pendant une démonstration commerciale.
Intégrer les tests au travail quotidien de l’équipe
Dans une démarche Agile et DevOps, les tests accompagnent les changements plutôt que d’arriver uniquement en fin de développement. Les développeurs prennent généralement en charge les tests proches du code ; les testeurs et la QA contribuent aux scénarios, aux risques et à l’exploration. Le Product Owner clarifie les attentes métier, tandis que les équipes DevOps facilitent les environnements et l’exécution.
- Définissez les comportements attendus et attribuez un responsable à chaque suite.
- Préparez un environnement reproductible et des données dédiées, synthétiques ou correctement anonymisées.
- Automatisez la préparation et le nettoyage pour rendre les tests indépendants.
- Exécutez les contrôles rapides à chaque changement et les suites plus longues selon leur coût et leur utilité.
- Conservez les rapports et organisez le traitement des échecs.
Un pipeline peut commencer par les tests unitaires, poursuivre avec les tests d’intégration, puis lancer quelques parcours critiques avant une livraison. Les campagnes longues de performance ou de sécurité peuvent suivre un rythme distinct. L’objectif est de fournir un signal utile assez tôt pour agir, sans ralentir inutilement toutes les modifications.
Un test intermittent, ou flaky test, doit être diagnostiqué : données partagées, dépendance externe, synchronisation ou environnement instable. Le relancer jusqu’à obtenir du vert masque le problème. Si une mise à l’écart temporaire est nécessaire, associez-lui un responsable et une échéance de correction.
Mesurer la confiance obtenue et le coût pour la maintenir
Le nombre de scripts ne suffit pas à mesurer la réussite. Suivez les risques métier couverts, les défauts détectés avant livraison, les régressions échappées en production, la durée du pipeline et le temps de maintenance. Ajoutez la fréquence des échecs intermittents : une suite bruyante finit par être ignorée.
La couverture de code mérite aussi une lecture prudente. Atlassian mentionne une couverture proche de 100 % comme objectif dans certains scénarios. Cela ne constitue pas un seuil universel : exécuter une ligne ne garantit pas qu’une assertion détectera un résultat incorrect.
Pour estimer la rentabilité sur une période donnée, comparez le temps de vérification manuelle réellement évité aux coûts de création, d’exploitation, de maintenance et d’analyse des échecs. Un ROI financier peut ensuite se calculer ainsi : gains nets divisés par coûts engagés, multipliés par 100. Séparez les économies mesurées des bénéfices estimés liés aux incidents évités.
Commencez par une couverture limitée mais fiable, puis étendez-la lorsque les résultats le justifient. Supprimez les tests obsolètes et conservez l’exploration humaine : une automatisation utile protège les livraisons sans devenir un second logiciel plus difficile à maintenir que le premier.
- Automatisation des tests : sécuriser les livraisons sans multiplier les scripts fragiles - 3 novembre 2026
- Développement d’application mobile en entreprise : cadrer les usages avant de comparer les devis - 2 novembre 2026
- Formation pour habilitation électrique : choisir le bon symbole avant de s’inscrire - 1 novembre 2026
Articles qui pourraient vous intéresser :
 Matrice AMDEC : 3 étapes pour calculer la criticité et sécuriser vos processus
 Développement sur mesure : pourquoi l’unique surpasse le standard pour votre croissance
 Créer un logiciel utile commence par le besoin, le MVP et les tests
 Structure site web : menus, silos et liens internes pour une navigation claire